Existe um ladrão silencioso de produtividade em toda operação de TI: a tarefa repetitiva. Classificar, atribuir, mudar prioridade, avisar o gestor — feitas à mão, centenas de vezes por semana. O módulo de Automação do Portal Nyverra ITSM existe para devolver esse tempo ao time.
Este guia explica como funcionam as regras, o que dá para automatizar, como acompanhar as execuções e onde entra o designer visual.
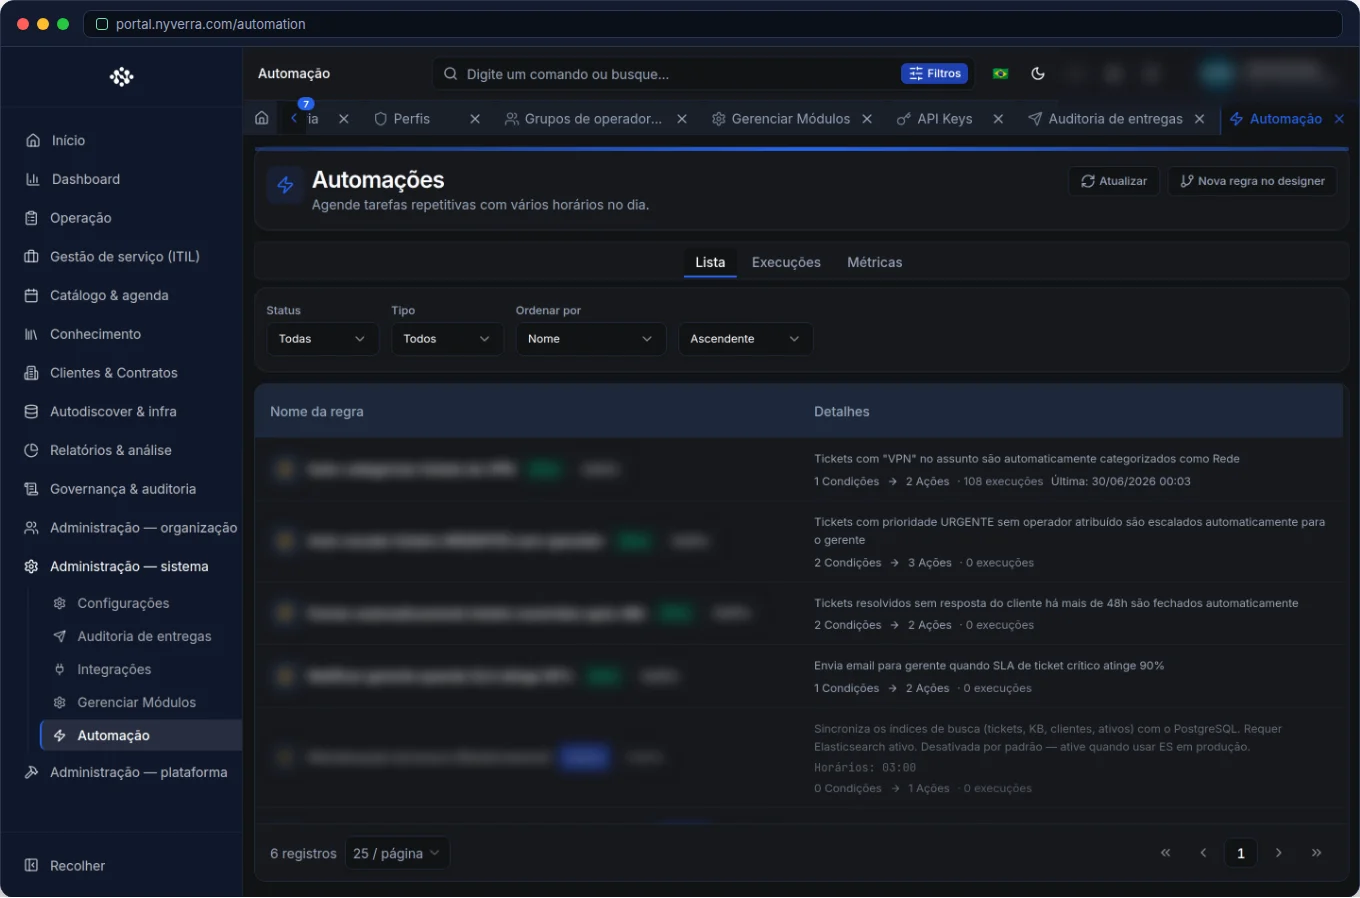 Interface do módulo no Portal Nyverra ITSM.
O que é uma regra de automação
É uma instrução condição → ação. O motor observa eventos no Portal e, quando a condição é satisfeita, executa uma ou mais ações — sem intervenção humana. É o “se isso, então aquilo” aplicado ao atendimento.
| Condição (exemplos) | Ação (exemplos) |
|---|---|
| Chamado criado na categoria “Rede” | Atribuir ao grupo de Rede |
| Urgência “Crítica” | Notificar gestor e aplicar SLA prioritário |
| Pedido de acesso | Iniciar fluxo de aprovação |
| Status alterado para “Pendente” | Pausar SLA e avisar solicitante |
O que dá para automatizar
- Roteamento: encaminhar por categoria, tipo, cliente ou urgência.
- Prioridade: definir/ajustar prioridade automaticamente.
- Notificações: avisar as pessoas certas em cada evento.
- Fluxos: iniciar aprovações ou tarefas padrão.
- Higiene: regras de acompanhamento e lembretes.
Gestão das regras
| Operação | O que faz |
|---|---|
| Ativar/desativar | Liga/desliga uma regra sem apagá-la |
| Duplicar | Clona uma regra como base para outra |
| Excluir | Remove a regra |
| Histórico de execuções | Mostra quando e como a regra disparou |
O histórico de execuções é o que transforma automação de “caixa-preta” em ferramenta confiável: você vê o que a regra fez e quando.
Designer visual e dry-run
Regras simples cabem em uma linha. Para fluxos mais elaborados, há um designer visual (editor de regras), útil para orquestrar múltiplas condições e ações. E, sempre que possível, o ideal é testar (dry-run / teste com um caso real) antes de deixar a regra ativa em produção.
Quem usa
| Perfil | Uso |
|---|---|
| Administrador | Criar, testar e manter regras |
| Gestor de serviços | Definir as políticas que a automação implementa |
Como usar: passo a passo
- Identifique tarefas repetitivas (roteamento, prioridade, avisos).
- Crie a regra (condição + ações).
- Teste com um caso real antes de ativar.
- Ative e acompanhe o histórico de execuções.
- Ajuste conforme o comportamento real.
Regras de negócio e cuidados
| Ponto | Explicação |
|---|---|
| Conflitos | Regras que competem entre si geram efeitos inesperados — mantenha-as coerentes. |
| Previsibilidade | Nomeie e documente cada regra; automação opaca é risco. |
| Alcance | Regras valem para a instância; revise o impacto antes de ativar. |
| Auditoria | O histórico permite investigar por que algo foi (ou não) executado. |
Boas práticas
- Comece por poucas regras de alto impacto (roteamento e prioridade).
- Nomeie e documente cada regra — futuros administradores agradecem.
- Teste antes de ativar; monitore as primeiras execuções.
- Revise regras que conflitam ou que não disparam mais.
- Use o designer visual só quando a complexidade justificar.
Erros comuns
| Situação | O que fazer |
|---|---|
| Chamado roteado errado | Revise a condição e conflitos entre regras. |
| Regra “fantasma” | Confira o histórico de execuções e o estado (ativa/inativa). |
| Automação opaca | Documente; sem clareza, vira dívida técnica. |
Perguntas frequentes
Automação substitui o operador?
Não — ela tira o repetitivo e libera o time para o que exige julgamento.
Posso testar antes de ativar?
Sim, com teste/dry-run quando disponível.
Como sei o que a regra fez?
Pelo histórico de execuções.
Automatize via API
As regras são expostas por API (/api/automacao e logs de execução). Referência em developer.nyverra.com.
Cenários de uso: o que automatizar primeiro
1. Roteamento automatico. Chamado com categoria “Rede” vai direto para o grupo de Rede — sem triagem manual. É a automação de maior impacto, porque ataca o gargalo diário do service desk.
2. Prioridade e SLA. Urgência “Crítica” aplica SLA prioritário e notifica o gestor. A regra garante que o crítico nunca fique tratado como rotina.
3. Fluxo de aprovação. Pedido de acesso inicia automaticamente as etapas de aprovação, poupando o solicitante de “descobrir o processo”.
4. Higiene operacional. Chamados parados recebem lembrete; status “aguardando cliente” pausa o SLA e avisa o solicitante.
KPIs de automação
| Indicador | O que revela |
|---|---|
| Regras ativas | Nível de automação |
| Execuções por período | Uso real das regras |
| Regras sem execução | Automação “morta” |
| Conflitos/erros de regra | Precisão das condições |
Automação com critério
O maior risco da automação é a opacidade: regras que agem sem ninguém entender por quê. Mitigue com nomes claros, documentação, teste antes de ativar e monitoramento do histórico de execuções. Comece por poucas regras de alto impacto, meça o efeito e expanda. Assim, a automação reduz trabalho manual sem esconder o que está acontecendo por baixo do capô — o que é o único jeito de ela ser confiável a longo prazo.
Checklist de automação
- Identifique tarefas repetitivas.
- Crie regras de alto impacto primeiro.
- Teste antes de ativar.
- Monitore o histórico de execuções.
- Revise conflitos entre regras.
- Documente cada regra.
Perguntas frequentes adicionais
A automação substitui o operador?
Não; tira o repetitivo e libera o time.
Como saber por que algo foi roteado?
Pelo histórico de execuções das regras.
Posso desligar uma regra sem apagá-la?
Sim, usando ativar/desativar.
Conclusão
Com Automação, o Portal Nyverra ITSM trabalha 24/7 roteando, priorizando e comunicando. Feita com critério — regras claras, testadas e monitoradas — ela reduz o trabalho braçal e deixa o time focar no que realmente precisa de gente.
Continuar a ler
Leia também
 Kubernetes
 de Verdade — do zero ao cluster em produção
Uma trilha prática para entender, montar e operar um cluster Kubernetes — do primeiro pod ao failover do Postgres.
4 min de leitura Kubernetes
Curso Kubernetes 28 — DR e capstone: provar que o cluster volta
RPO, RTO e drills reais: cenários de desastre, runbook, restore medido e o capstone que fecha o curso com um cluster que se recupera.
5 min de leitura Kubernetes
Curso Kubernetes 27 — SLO/SLI, on-call e postmortem blameless
O que prometer, como medir e o que fazer quando o erro estoura: SLI, SLO, error budget, alertas que acordam alguém e postmortem sem caça às bruxas.
4 min de leitura
Comentários
Ainda sem comentários
Seja o primeiro a compartilhar sua opinião sobre este artigo.


Deixe um comentário